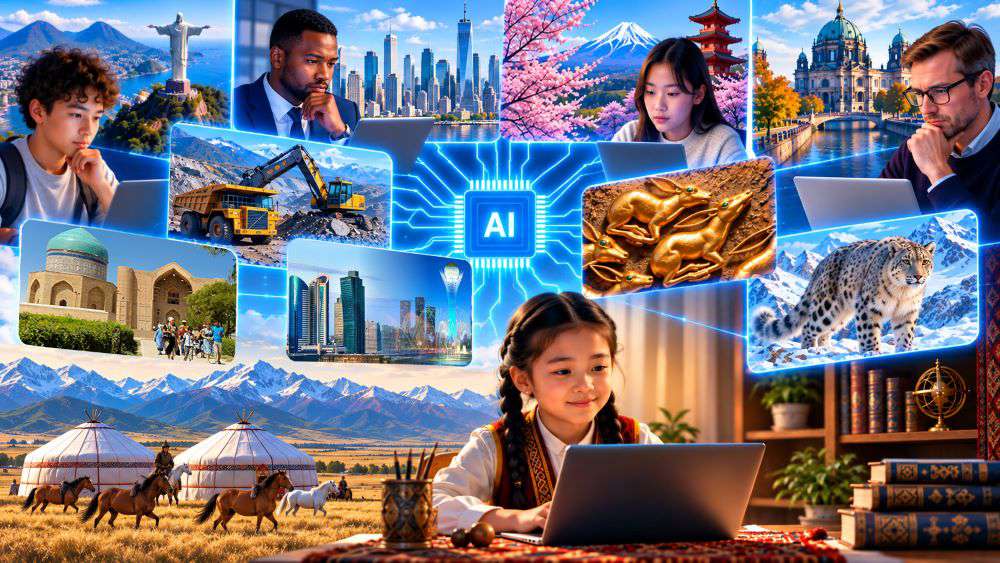
Какими нас увидит искусственный интеллект? Статьи,Мысли вслух 16 сентября 2026 г. 0:40 Бахытжан Бухарбай, политолог (Продолжение. Начало Какими нас увидит искусственный интеллект?) коллаж Павла Цедилина при помощи ChatGPT Постановка вопроса Представим простой эксперимент. Через десять лет школьник в Бразилии спрашивает искусственный интеллект, кто такие казахи. Американский предприниматель просит машину объяснить ему, что такое Казахстан. Японский студент хочет понять нашу культуру. Немецкий исследователь изучает историю Центральной Азии. Наконец, казахский ребенок разговаривает со своим персональным AI-учителем и задает ему вопросы о собственной стране. Откуда машина получит ответы? И, что гораздо важнее, каким в них окажется Казахстан? До появления искусственного интеллекта представление о народе складывалось из книг, энциклопедий, газет, фильмов, университетских исследований, телевидения, а позже – поисковых систем и социальных сетей. Теперь между всеми этими источниками и человеком появляется модель, которая сама собирает из огромного цифрового массива некоторое представление о мире. Следовательно, возникает вопрос, которого еще несколько десятилетий назад перед государствами практически не существовало: кто будет объяснять машине, кто мы такие? Проблема касается далеко не только Казахстана. UNESCO насчитывает более семи тысяч языков, которые сегодня используются в мире, однако лишь около тысячи из них представлены онлайн. Организация прямо предупреждает, что распространение искусственного интеллекта может усилить уже существующий языковой дисбаланс, если огромная часть человечества будет значительно хуже представлена в цифровом пространстве. Именно поэтому в 2025 году UNESCO запустила Глобальную дорожную карту по многоязычию в цифровую эпоху, подготовленную после консультаций, в которых приняли участие представители 53 стран. Возникает довольно странное неравенство. Одни народы входят в искусственный интеллект целыми библиотеками, другие – несколькими книжными полками, третьи рискуют войти туда сноской. Причем размер физической территории здесь не дает никакой гарантии. Маленькая страна способна обладать огромным цифровым присутствием, а огромная – почти не существовать в глобальном пространстве машинного знания. Плотность цифровой территории Но здесь я бы предложил пойти еще дальше. Возможно, у цифровой территории есть не только размер, но и плотность. Мы привыкли измерять пространство квадратными километрами. Цифровую территорию, вероятно, придется измерять иначе: сколько на твоем языке существует современной физики, биологии, экономики, медицины, инженерии, философии? Насколько хорошо на нем можно обсуждать квантовые вычисления, генную инженерию, современные материалы или архитектуру нейронных сетей, не переходя автоматически на более сильный язык? Сколько современных людей, идей, компаний, научных исследований и интеллектуальных дискуссий представлены в доступном машине массиве? Можно разместить в Интернете миллионы страниц – и все равно остаться цифровой провинцией, если практически вся интеллектуальная жизнь на собственном языке обращена назад. И здесь возникает еще один вопрос, значительно более важный, чем простой объем данных. Предположим, мы оцифровали всю казахскую литературу, открыли архивы, создали огромные языковые корпуса, записали разговорную речь, перевели научную терминологию и добились того, чтобы ведущие мировые системы прекрасно говорили по-казахски. Можно ли после этого считать задачу выполненной? Мне кажется, нет. Потому что вслед за вопросом о количестве казахского содержания возникает гораздо более сложный вопрос о самом содержании. Какого именно казаха увидит искусственный интеллект? Память и культ жертвенности Здесь необходимо сделать принципиальную оговорку. Было бы совершенно неправильно объявлять казахскую культуру только культурой страдания. У нас огромная литература, эпос, философия, музыка, поэзия, юмор, интеллектуальная традиция. Было бы тем более глупо предлагать забыть трагические страницы нашей истории. Джунгарские войны, колониальная политика, Ашаршылық, репрессии, Семипалатинский полигон были. Все это необходимо изучать и помнить. Историческая амнезия никогда не делала общество сильнее. Но существует принципиальная разница между памятью о жертвах и культом собственной жертвенности. Память говорит: это произошло с нами, мы должны понять причины и не допустить повторения. Культ жертвы незаметно начинает говорить: это и есть мы. В первом случае прошлое дает обществу опыт, во втором превращается в универсальное объяснение настоящего. И именно здесь искусственный интеллект создает совершенно новую сложность. Мы привыкли считать, что главное – произвести как можно больше контента на казахском языке. Но количество само по себе ничего не решает. Если мы создадим огромный цифровой корпус, непропорционально большая часть которого будет рассказывать о поражениях, исторических обидах, внешнем угнетении, национальных травмах и маленьком человеке, от которого ничего не зависит, мы действительно увеличим присутствие казахов внутри искусственного интеллекта. Только возникает вопрос: каких казахов? Можно оцифровать язык и одновременно законсервировать мировоззрение. Машина XXI века вполне способна масштабировать смыслы, которые общество производило в совершенно других исторических обстоятельствах. Самая современная технология человечества может оказаться чрезвычайно эффективным инструментом воспроизводства очень старого сознания, в котором человек – маленький, обстоятельства – велики, власть находится где-то далеко наверху, судьба сильнее личности, а история преимущественно происходит с нами, но значительно реже создается нами. Разумеется, утверждать без специального исследования, что именно такой контент доминирует во всем казахском цифровом пространстве, было бы интеллектуально нечестно. Это требует полноценного анализа литературы, журналистики, школьных текстов, кино и цифровых медиа. Но поставить этот вопрос мы обязаны уже сейчас, потому что недостаточно спрашивать, сколько казахского языка попадет внутрь искусственного интеллекта. Не менее важно понимать, какую модель человека этот огромный массив текстов будет воспроизводить. Не собственность, а субъектность И вот здесь метафора цифрового феодализма приобретает для нас совсем другой смысл. Если американские или китайские технологические гиганты действительно превращаются в своеобразных владельцев цифровой земли, то наше положение нельзя определять только вопросом, есть ли у Казахстана собственные серверы и модели. Потому что крепостным делает человека не только отсутствие собственности, но и отсутствие субъектности – а это уже совсем другая, куда более глубокая проблема. Можно жить в независимой стране, иметь собственный язык и при этом существовать внутри цифровой реальности, которую описали другие, по установленным ими правилам, используя знания, собранные кем-то, и даже смотреть на самого себя глазами алгоритма, обученного преимущественно чужими текстами. Это, возможно, и есть наиболее опасная версия цифрового феодализма для малых и средних культур. Не та, при которой какой-нибудь технологический миллиардер начинает лично нами править, – такое сравнение было бы слишком примитивным. А та, при которой он владеет цифровой землей, а у нас пока недостаточно собственной инфраструктуры, чтобы перестать быть на ней зависимыми. Причем здесь появляется еще одна историческая параллель, о которой стоит сказать честно. В нашей истории уже случались долгие периоды, когда условия существования народа во многом определялись извне, и это можно назвать формой зависимости, в чем-то похожей на тот самый феодальный принцип: кто-то другой решает, как тебе жить, работать и говорить. Риск в том, что мы можем совершить прямой скачок из этого прошлого опыта несвободы сразу в несвободу цифровую, минуя тот этап, на котором общество успевает по-настоящему освоить, что значит самому распоряжаться собственной судьбой. Мы можем войти в эту новую систему не только без цифровой собственности, но и с психологией, сформированной еще прежним устройством зависимости: обучить машину прекрасно говорить по-казахски и оставить в самом языке фигуру человека, за которого все решают другие; оцифровать всю национальную библиотеку, но так и не создать достаточного количества новых историй о людях, которые не терпят историю, а делают ее. Тогда снаружи общество окажется в XXI веке, а внутри машины останется его старый, до конца не изжитый двойник. И вот здесь технологическая модернизация сталкивается с ограничением, которое невозможно решить импортом оборудования. Технологию и сервера можно купить, модель – лицензировать, инженеров – пригласить. Субъектность же импортировать невозможно. Она появляется только там, где общество десятилетиями рассказывает человеку, что он способен создавать, исследовать, рисковать, принимать решения, брать на себя ответственность и менять окружающую реальность. В этом смысле язык имеет значительно более важную функцию, чем сохранение идентичности. У зрелой нации должно быть не только прошлое и настоящее, но и будущее время. Именно поэтому нам не нужно меньше книг об Ашаршылық, меньше исследований репрессий или разговоров о колониальном прошлом. Нам нужно больше настоящего и значительно больше будущего: современной научно-популярной литературы на казахском языке, философии, экономики, естественных наук, современной прозы и хороших детских книг, в которых ребенок – не только наследник великого прошлого, но и потенциальный создатель великого будущего. Нам нужны истории, в которых казах не только тот, с кем что-то произошло, но и тот, благодаря кому что-то произошло. Это не призыв к позитивному мышлению и не попытка заменить сложную историю набором мотивирующих биографий. Речь идет о полноте национального образа. Если общество производит главным образом память, его цифровой двойник будет прекрасно помнить. Если оно одновременно производит науку, технологии, литературу, философию, бизнес, новые культурные смыслы и представление о человеке, машина увидит совершенно другую картину. Суверенитет представления Поэтому рядом с понятием технологического суверенитета, на мой взгляд, стоит ввести еще одно – суверенитет представления. На протяжении столетий образ народа формировали семья, школа, литература, историки, поэты, газеты, телевидение и кино. Потом к ним добавился Интернет. Теперь появляется еще один посредник – искусственный интеллект. Машина сама по себе не создает национальную идентичность, но она становится инструментом, через который миллиарды людей будут получать знания о народах, странах и культурах. И способность общества участвовать в формировании собственного образа внутри этой системы постепенно превращается из вопроса культурной политики в вопрос национального суверенитета. Причем речь совершенно не идет о цензуре, создании лакированной государственной версии истории или попытке загрузить в искусственный интеллект образ какого-то идеального казаха. Это было бы не только опасно, но и бессмысленно. Наоборот, цифровой образ народа должен быть сложным, разнообразным и честным. В нем должны быть поражения и победы, герои и жертвы, трагедия и юмор, традиция и современность. Проблема появляется тогда, когда одно историческое состояние народа начинает претендовать на исчерпывающее описание всей нации. Но есть еще одна причина, почему заниматься этим нужно уже сейчас. Через несколько лет искусственный интеллект будет не только рассказывать иностранцам о нашей стране. Он будет объяснять Казахстан самим казахам. И вот здесь возникает совершенно новая культурная петля: мы создаем тексты о себе, на них и других данных учится машина, следующее поколение начинает получать значительную часть знаний уже через нее, а затем это поколение создает свои истории, которые снова попадают в цифровую среду. Получается механизм обратной связи, которого раньше никогда не существовало в таком масштабе: мы объясняем машине, кто такие казахи, а затем она начинает объяснять нам, кто мы такие. Представим ребенка, родившегося через десять лет. Для него искусственный интеллект, скорее всего, будет настолько же естественным источником знания, каким для нас были энциклопедия, учитель и поисковая система, вместе взятые. Он спросит машину о нашей истории, о героях, о том, кем может стать человек из Казахстана. Если в цифровом массиве десятки тысяч текстов подробно объясняют ему, как наш народ страдал, но значительно меньше текстов рассказывают, что мы создавали и что способны создать завтра, машина не обязательно будет лгать. Она просто очень точно воспроизведет наш собственный дисбаланс. И тогда мы получим удивительный результат: старое сознание приобретет самую современную в мире систему доставки. Что делать: индекс присутствия Именно поэтому политика казахского присутствия в искусственном интеллекте не может ограничиваться переводом интерфейсов или созданием одной национальной языковой модели. Нужны большие и юридически чистые корпуса казахского языка, оцифрованные библиотеки и архивы, научные статьи и учебники, современная литература, разговорная речь, аудиокорпуса, терминологические базы и качественные переводы. Нужны собственные тесты для оценки AI-моделей, позволяющие измерять не только грамматику, но и глубину понимания истории, культуры и современного Казахстана. Возможно, наряду с привычными показателями цифровизации стране вообще понадобится национальный индекс присутствия в искусственном интеллекте – не очередной формальный международный рейтинг, а регулярный аудит ведущих моделей. Насколько хорошо они понимают казахский? Каких людей называют, когда их спрашивают о Казахстане? Насколько полно знают современную страну, а не только ее историю? Понимают ли научную терминологию? Способны ли работать с разговорной речью? Какие ошибки и культурные искажения систематически воспроизводят? Мы измеряем инфляцию, уровень грамотности, качество воздуха, состояние дорог и скорость Интернета. Почему бы не начать измерять качество собственного присутствия внутри системы, которая постепенно становится одним из главных интерфейсов человеческого знания? Именно здесь цифровая территория из красивой метафоры превращается во вполне практическое понятие. Физическую территорию государства можно измерить один раз – она либо есть, либо ее нет. Цифровая территория расширяется ежедневно. Каждый новый научный текст на казахском языке, каждая качественно оцифрованная книга, база научных терминов, биография современного ученого, инженерное исследование, хороший учебник, современный роман, фильм, лекция или архивный документ добавляют еще один участок в пространство, внутри которого машина способна понимать нас. Но главное здесь даже не объем. Важно – что именно мы на этой территории строим. Можно обладать большой цифровой территорией и заполнить ее музеями собственного прошлого, а можно построить на ней лаборатории будущего. Возможно, именно это и будет одним из главных различий между цифровыми субъектами и теми, кто просто существует внутри чужой системы. Первые производят знания, смыслы, технологии и представление о самих себе. Вторые получают готовые инструменты, ответы и картину мира, постепенно привыкают жить внутри нее. Право самим себя объяснять На протяжении столетий народы боролись за землю. Потом они боролись за государственность. Позже – за собственные школы, университеты, язык, книги, газеты, радио и телевидение. Каждый раз речь в конечном счете шла об одном и том же: о праве самостоятельно существовать и описывать себя. Теперь появляется еще одно пространство этой борьбы. Впервые в истории мы создаем не только национальную память для собственных потомков – мы создаем память о себе для машин. Впрочем, даже эта формулировка, возможно, уже недостаточна: мы создаем память о себе для людей, которые будут познавать мир через машины. И это принципиальная разница. Поэтому вопрос уже не только в том, будет ли искусственный интеллект понимать казахский язык. Гораздо важнее другое: какого казаха он поймет? А если сделать еще один шаг, то вопрос становится почти тревожным: какого казаха искусственный интеллект однажды поможет увидеть в себе самому казаху? Человека, которому история постоянно что-то делала, или человека, который сам способен что-то сделать с историей? Конечно, настоящая нация значительно сложнее этого противопоставления. В ней существуют память и мечта, трагедия и победа, жертва и герой, прошлое и будущее. Но именно поэтому ее цифровой образ тоже должен быть сложным. Нельзя позволить одному историческому состоянию человека превратиться в исчерпывающее описание целого народа. Мы любим бравировать девятым местом Казахстана по площади. Но на карте XXI века наши 2,7 млн кв. км не дают нам никакой форы. Там территория измеряется уже не степями, горами и месторождениями, а языком, знаниями, данными, научными школами, технологиями, культурными образами и смыслами, которые общество способно производить и оставлять после себя. Можно быть географическим гигантом и цифровым карликом, хозяином собственной земли и цифровым крепостным, обладателем государства без собственного голоса внутри машинного знания. Если XXI век действительно породит цифровых феодалов, наша задача состоит не в том, чтобы найти себе хорошего феодала. Наша задача – не стать цифровыми крепостными. Физическую землю нам оставили предки. Цифровую свободу потомкам должны оставить мы. #Казахстан #цифровизация #искусственный интеллект #Бахытжан Бухарбай #мысли вслух
11 сентября 2026 г. 0:30 Олжас Бектенов: Уйти от разрозненных ИС к единому цифровому контуру здравоохранения
29 августа 2026 г. 16:05 Свыше 16 тыс нарушений выявили в Казахстане в рамках акции «Внимание — дети!»
22 августа 2026 г. 12:00 Свыше 11 тыс. казахстанских семей получают господдержку в виде субсидирования арендного жилья
30 августа 2026 г. 18:50 250 тысяч зрителей и новая система безопасности: как в Караганде прошел масштабный концерт